深度介绍
MLC-LLM详细介绍
🧱三步工作流:下载、编译、运行
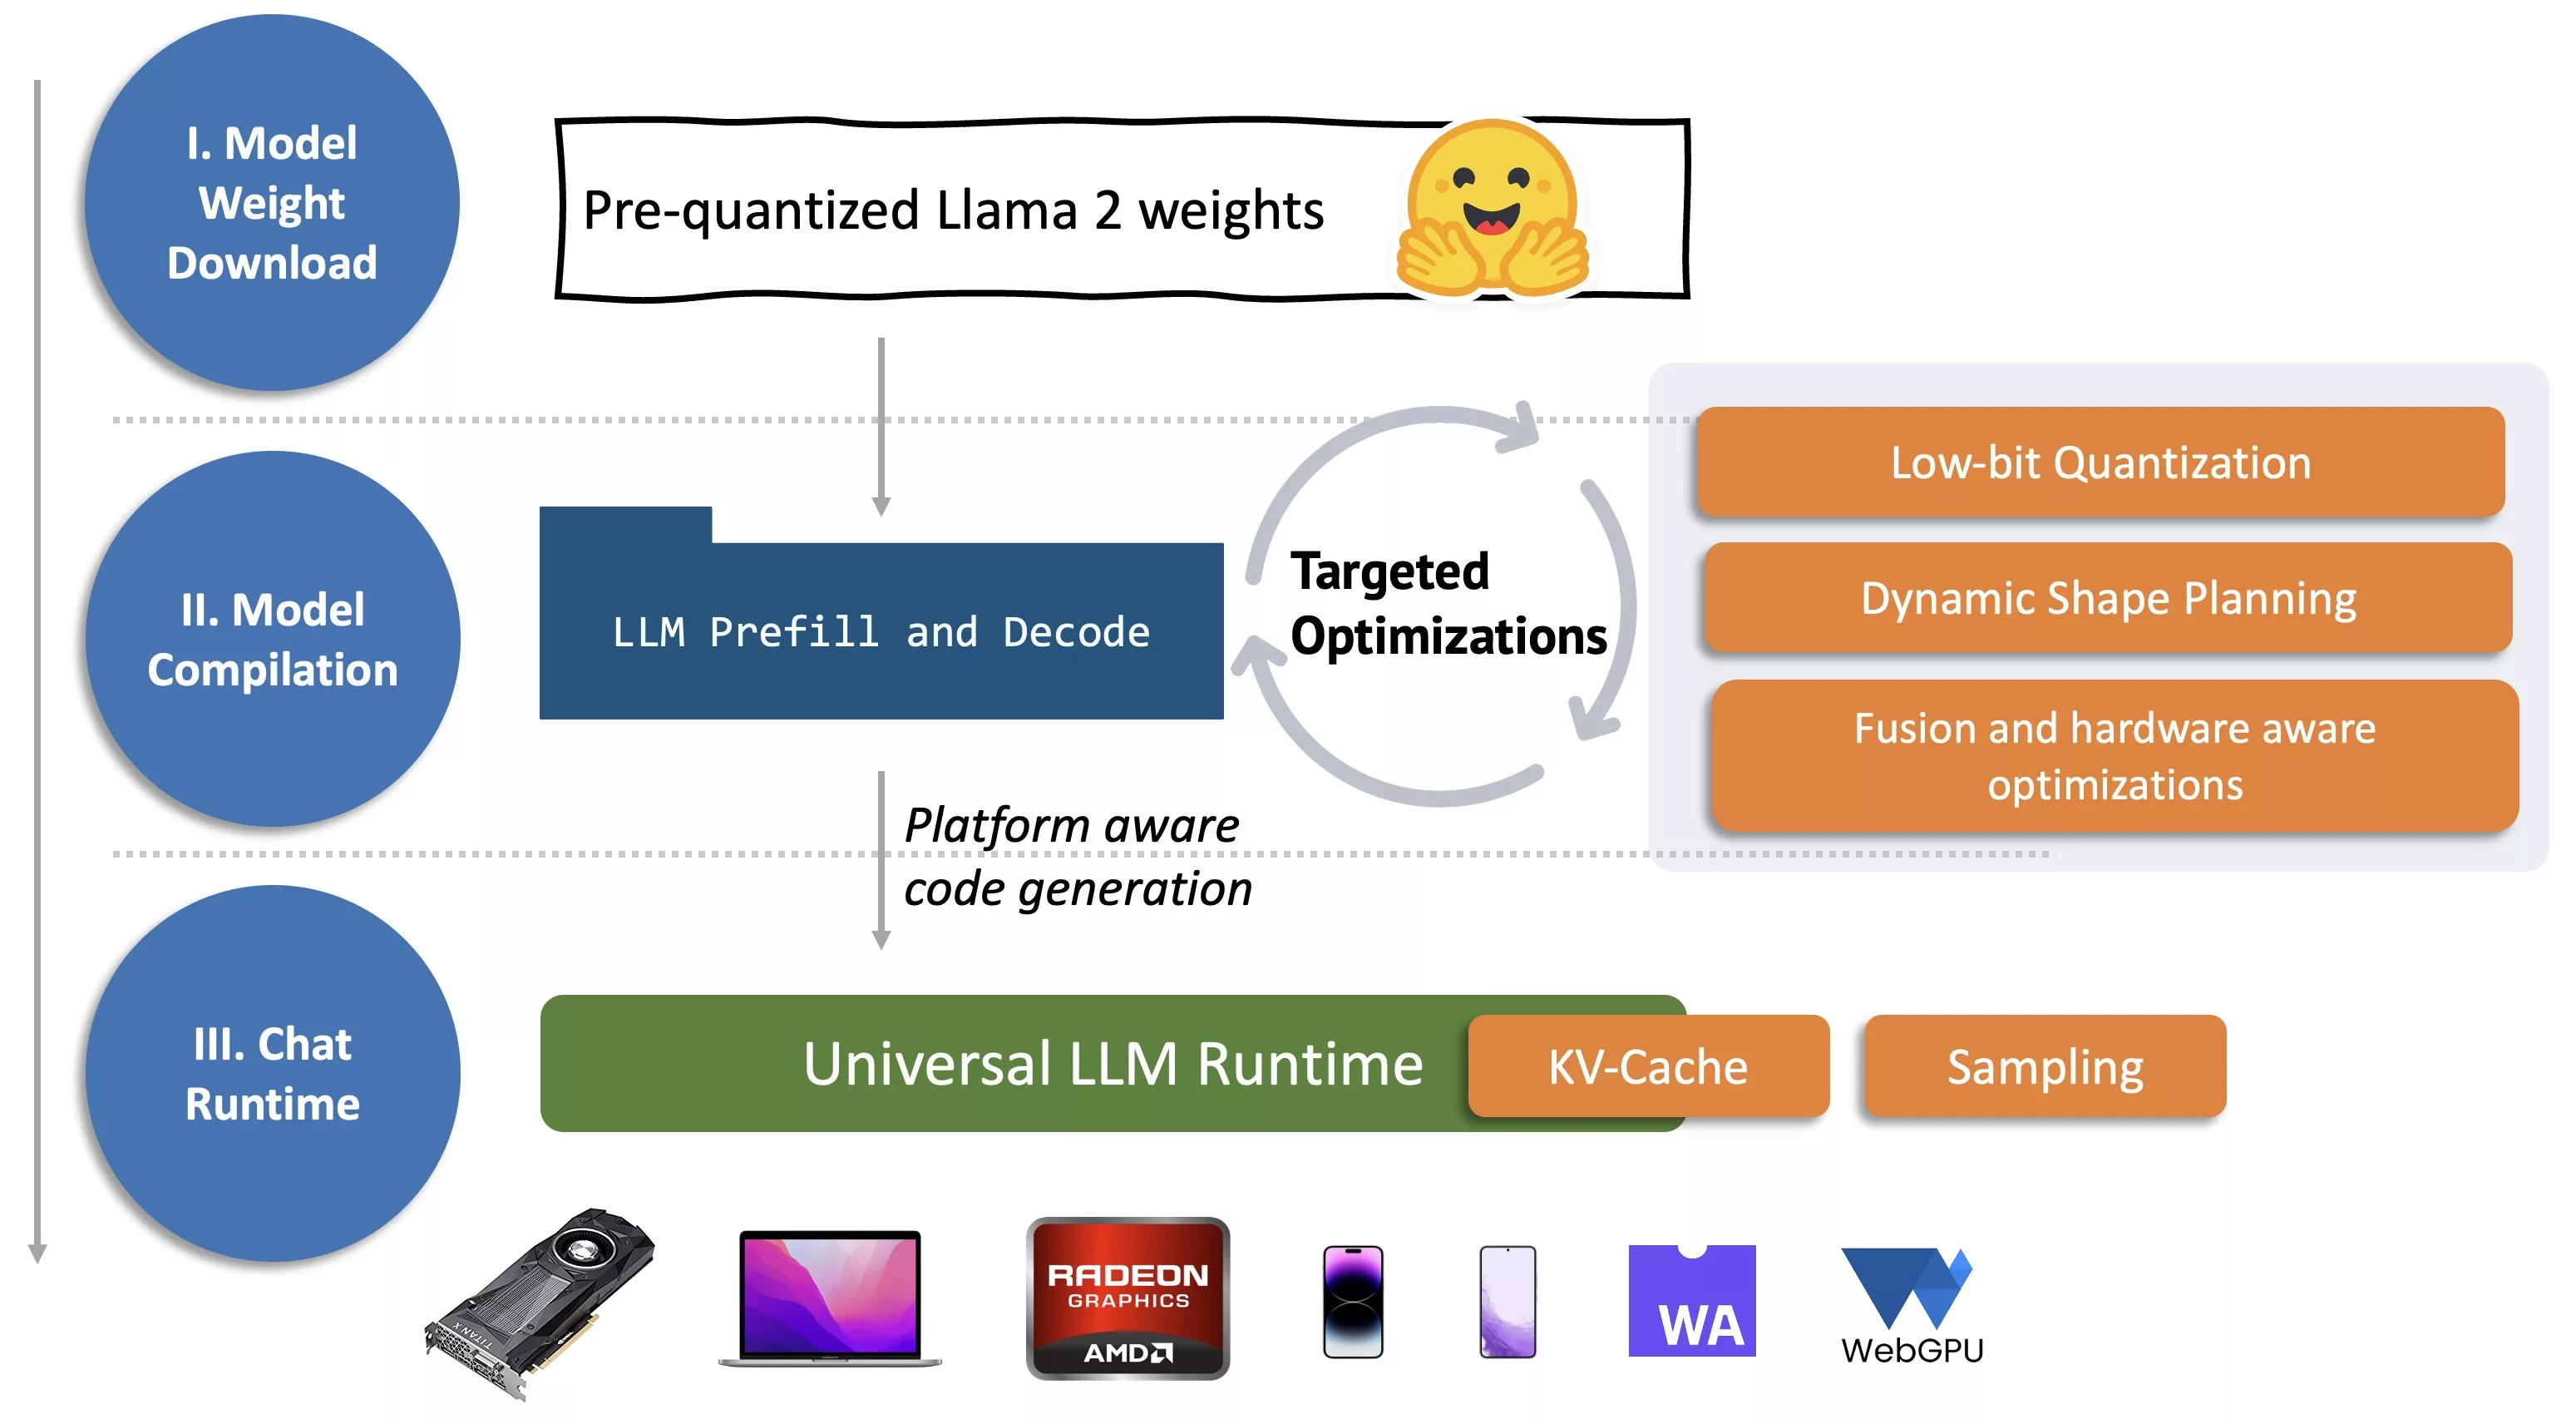
官方把一个模型从权重到可运行的过程拆成三个阶段:第一阶段从 Hugging Face 自动下载预量化权重并放进本地缓存;第二阶段用 Apache TVM 的机器学习编译把模型针对本机 GPU 优化,生成二进制模型库;第三阶段由平台原生运行时加载权重与模型库开始推理。关键在于前两个阶段会被缓存,只在首次运行时执行,之后启动就不再重复下载与编译。以 4-bit 量化的 8B 模型为例,官方提示首次运行大约需要一两分钟。理解这条链路也有助于定位问题:下载慢属于网络问题,编译慢是首次成本,运行慢才需要回头看硬件与量化配置。
MLCEngine:一个引擎,多种语言入口
MLCEngine 是统一的高性能推理引擎,官方强调 REST 服务器、Python、JavaScript、iOS 与 Android 都由同一套引擎与编译器支撑。Python 侧的接口刻意与 OpenAI 对齐:用 MLCEngine 创建实例后直接调用 engine.chat.completions.create,流式与非流式写法都和 OpenAI 的 Python 包一致,另有 AsyncMLCEngine 面向并发异步生成。REST 服务器用一条命令启动(mlc_llm serve),默认监听本地 8000 端口,官方称提供完整的 OpenAI API 支持,把 base_url 指过来就能接入现有客户端与工具链。对已在用 OpenAI SDK 的项目,这种对齐能省掉大部分改造工作。
跨硬件矩阵:四类 GPU 与三种系统
官方 README 给出平台矩阵:Linux 与 Windows 上支持 AMD GPU(Vulkan、ROCm)、NVIDIA GPU(Vulkan、CUDA)与 Intel GPU(Vulkan);macOS 上通过 Metal 支持 Apple GPU,也覆盖 AMD 独显与 Intel 核显;浏览器里用 WebGPU 与 WASM;iOS 与 iPadOS 用 Metal 跑在 Apple A 系列 GPU 上;Android 上通过 OpenCL 支持高通 Adreno 与 ARM Mali。同一个引擎覆盖这些目标,意味着模型不必为每种终端重写;但各平台算力与内存差异很大,官方建议先从较小的模型试起,再根据实测结果决定是否上更大参数量。
WebLLM:把推理搬进浏览器
MLC-LLM 会为 WebGPU 与 WebAssembly 生成代码,因此大模型可以完全在网页里本地运行、不占用服务器资源,这条路线由关联项目 WebLLM 承接。快速开始页说明:预量化权重由 WebLLM 自行下载,预编译的模型库(即 WebGPU 代码)也会自动获取,使用者只需要一个支持 WebGPU 的浏览器——官方点名最新版 Chrome,并推荐用 WebGPU Report 检查浏览器能力。对做演示或隐私敏感场景的团队,价值在于数据不出浏览器;代价是模型规模受客户端显存限制,且首次加载要等待权重下载完成。
移动端:开源的 MLC Chat 应用
官方提供 iOS 与 Android 端的 MLC Chat:iOS 版本已上架 App Store,Android 提供预编译 APK,README 说明该演示在高通骁龙 8 Gen 2(三星 S23)、骁龙 685(Redmi Note 12 Pro)与 Google Pixel 上做过测试。两个应用的源码完全开源,文档里配有从零构建的教程,并提供 iOS Swift SDK 与 Android SDK。这让「把模型放进手机」变成可控的工程,而不是只能依赖云端接口。需要注意移动端的显存与内存都有限,官方建议从较小模型开始,并留意不同芯片在 OpenCL 与 Metal 上的支持差异。
自带模型:转换权重与编译模型库
如果不想只用官方预量化好的模型,文档给出两条进阶路径:转换模型权重与编译模型库。前者把 Hugging Face 上的原始权重转成 MLC 格式的量化权重;后者面向 Web、iOS 与 Android 等目标生成可执行库,并允许控制算子层面的优化选择。对需要适配自家模型或做性能调优的团队,这两步是绕不开的;对只想跑通现有模型的用户,官方预量化仓库(形如 mlc-ai 组织下带 q4f16_1 后缀的 MLC 仓库)已经够用,用 HF:// 前缀直接引用即可,不必自己转换。
量化与多卡:q4f16_1 与张量并行
官方示例默认使用 4-bit 量化模型,命名里的 q4f16_1 表示 4-bit 分组量化权重配合 fp16 激活;快速开始页提示跑通该示例建议至少 6GB 可用显存。多卡方面支持张量并行:命令行加 --overrides tensor_parallel_shards=2,或在 Python 里用 EngineConfig(tensor_parallel_shards=2),即可把模型切分到多张 GPU。这两个旋钮分别决定「能不能跑」与「跑多快」:先按可用显存确定量化位宽,再判断是否需要多卡,通常比反过来更省事。选型时也建议用真实提示词与上下文长度压测,而不是只看模型参数量。
上手前的注意点与实际边界
安装走 pip,官方建议放在独立的 conda 虚拟环境里;Windows 与 Linux 用户需要较新的 Vulkan 驱动,官方还建议用 conda 安装 gcc 与 libvulkan-loader,避免出现找不到 Vulkan 的问题。首次运行会经历下载与编译,耗时通常在一两分钟以上。仓库的 pyproject 标注当前版本为 0.20.0.dev0,要求 Python 3.9 以上,依赖包含 apache-tvm-ffi、FastAPI 与 uvicorn,Linux 侧还包含 FlashInfer。另外要注意:项目仍处于开发阶段,接口与包名可能变动;官方不提供托管服务,模型缓存、驱动版本与服务的安全边界都需要自行维护。
产品特点
核心功能与独有价值
01三步工作流与本地缓存
官方把流程拆成下载预量化权重、用 Apache TVM 编译模型库、平台原生运行时三个阶段,前两步只在首次执行并被缓存。以 4-bit 量化的 8B 模型为例,官方提示首次运行约一两分钟。
一个引擎覆盖桌面、浏览器与移动端
MLCEngine 同时支撑 REST 服务器、Python、JavaScript、iOS 与 Android,Python 与 REST 接口都与 OpenAI 对齐,可在不改造现有客户端的前提下接入本地模型。
四类 GPU 与 WebGPU、WASM 全覆盖
Linux 与 Windows 支持 AMD、NVIDIA、Intel GPU(Vulkan、ROCm、CUDA),macOS 走 Metal,浏览器走 WebGPU 与 WASM,iOS 与 Android 分别用 Metal 与 OpenCL。
开源移动应用与原生 SDK
iOS 端已上架 App Store、Android 端提供预编译 APK,两者源码完全开源并提供 Swift 与 Android SDK,官方演示在高通骁龙 8 Gen 2、骁龙 685 与 Pixel 机型上做过测试。
最近动态
重要更新
当前版本与依赖构成(核验时点)
截至 2026 年 9 月核验,仓库 pyproject 标注版本为 0.20.0.dev0,要求 Python 3.9 以上;运行依赖包含 apache-tvm-ffi、FastAPI、uvicorn、openai、torch、transformers 等,Linux 侧额外包含 FlashInfer。安装方式为 pip,官方建议使用独立的 conda 虚拟环境。
官方博客讨论微服务化的推理引擎
官方博客在 2025 年 1 月发布 Microserving LLM engines 一文,讨论把大模型推理引擎按微服务方式拆分的思路。相关内容属于工程方向探索,具体实现与是否合入主线以官方仓库当期状态为准。
MLCEngine 的高吞吐低延迟优化与刻画
官方博客 2024 年 10 月发布文章,对 MLCEngine 在高吞吐与低延迟场景下的表现做优化与刻画。MLCEngine 也正是当前统一推理引擎的名称,Python、REST 与移动端 SDK 都构建在它之上。
确定引擎与浏览器两条路线
2024 年 6 月官方先后发布 WebLLM 浏览器推理引擎与 MLC-LLM 通用部署引擎两篇说明,确立了本地引擎与浏览器内推理并行的两条技术路线;这也是当前文档结构的来源,WebLLM 至今仍作为关联项目维护。
产品总结
MLC-LLM 是面向大语言模型的机器学习编译器与高性能部署引擎,官方定位为「基于机器学习编译的通用大模型部署引擎」,目标是让开发者能在每个人的平台上原生开发、优化与部署模型。项目以 Apache-2.0 许可开源,技术底座来自 Apache TVM 体系(含 TensorIR 与 MetaSchedule 等张量程序优化工作),核验时仓库约有 2.3 万 star,pyproject 标注版本 0.20.0.dev0、要求 Python 3.9 以上。 它的工作流与常见推理框架不同:先从 Hugging Face 下载预量化权重,再用编译器把模型针对本机 GPU 优化成二进制模型库,最后由平台原生运行时加载执行;前两步只在首次运行并会缓存。官方示例以 4-bit 量化的 8B 模型起步,提示至少 6GB 可用显存、首次运行约需一两分钟。统一推理引擎 MLCEngine 同时支撑 REST 服务器、Python、JavaScript、iOS 与 Android,Python 与 REST 接口都与 OpenAI 对齐,用 mlc_llm serve 一条命令即可启动本地服务;多卡可用张量并行参数开启。 跨平台是它最突出的特点。官方平台矩阵覆盖 Linux 与 Windows 上的 AMD(Vulkan、ROCm)、NVIDIA(Vulkan、CUDA)与 Intel GPU(Vulkan),macOS 上的 Apple GPU 与 AMD、Intel 显卡(Metal),浏览器中的 WebGPU 与 WASM,iOS 与 iPadOS 上的 Metal,以及 Android 上针对 Adreno 与 Mali 的 OpenCL。浏览器路线由关联项目 WebLLM 承接,可完全不依赖服务器;移动端有开源的 MLC Chat 应用(iOS 已上架 App Store,Android 提供 APK)与 Swift、Android SDK。 使用前需要注意:安装走 pip 并建议独立 conda 环境,Windows 与 Linux 用户需较新的 Vulkan 驱动,必要时用 conda 安装 gcc 与 libvulkan-loader;首次运行含下载与编译开销;项目仍属开发版本,接口与包名可能变动,官方不提供托管服务;若要跑自家模型,需要经过权重转换与模型库编译两步;移动端与浏览器端的模型规模受设备显存限制,建议从小模型起步。整体而言,它适合需要把模型部署到多种终端、并愿意接受编译式工作流的团队。
- 产品类型
- 大模型编译与部署引擎
- 支持平台
- Python API(MLCEngine) / REST 服务器 / 命令行 chat 与 serve / WebLLM(浏览器 WebGPU / WASM / iOS Swift SDK / Android SDK / IDE 集成 / 张量并行多卡
- 资费模式
- 开源免费(Apache-2.0 许可);成本来自自备硬件或云算力,官方不提供托管推理服务。
核验信息
参考文章与数据来源
本页事实来自 MLC-LLM 官方渠道:GitHub 仓库 README(「基于机器学习编译的通用大模型部署引擎」定位、Apache-2.0 许可、平台支持矩阵、MLCEngine 与多语言入口、关联项目 WebLLM)与 pyproject(版本 0.20.0.dev0、Python 版本要求与依赖清单)、官方文档(三步工作流与缓存机制、pip 与 conda 安装建议、Vulkan 依赖提示、CLI 与 Python API 示例、张量并行参数、REST 服务器与 OpenAI 兼容支持、模型权重转换与模型库编译指引、移动端应用与 SDK)以及官方博客的发布时间线。star 数与版本信息核验于 2026 年 9 月 22 日,项目处于开发阶段,请以官方最新文档为准。
- 官网MLC-LLM 官网
- 其他MLC-LLM 官方仓库
- 官方文档官方文档
- 官方文档官方文档 · 快速开始
- 官方文档官方文档 · 工作流介绍
- 官方文档官方文档 · 安装说明
- 其他官方博客
- 其他关联项目 WebLLM
用户体验调查
MLC-LLM介绍页面对您是否有帮助?